c7w's blog

Diffusion-DDPM

发布于 # Learning

这一系列博文我们对 Diffusion 模型进行简单的介绍 :)
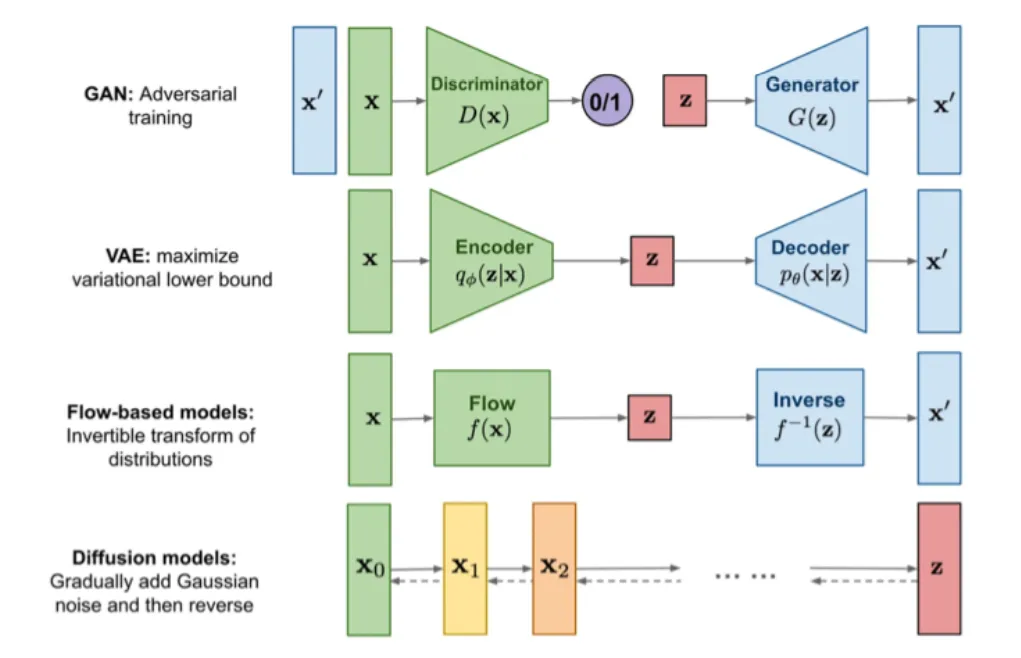
我们认为比较重要的 Paper List:

DDPM

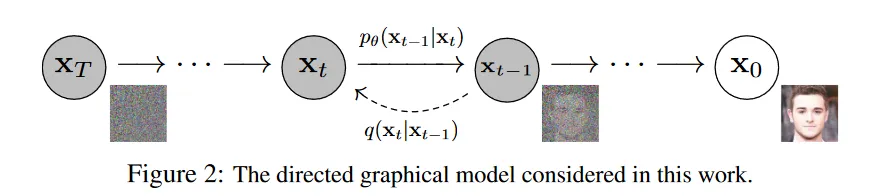
DDPM(Denoising Diffusion Probabilistic Models)是一种生成式模型,其可以将噪声 xT\mathbf{x}_T 经过一系列级联的去噪(Denoising)过程生成具有真实感的图像 x0\mathbf{x}_0。

在 DDPM 中,具有两个重要的过程:前向过程(forward process, or diffusion process)和去噪过程(denoising process):

前向过程

前向过程,也就是图中的 qq 过程,通过不断加高斯噪音的方式将原始数据分布 q(x0)q(\mathbf{x}_0) 转换为简单易处理的标准正态分布。在前向过程中,一个初始的噪声图像 xT\mathbf{x}_T 被迭代地与一系列高斯噪声进行混合,生成一系列经过随机扰动的图像 xt\mathbf{x}_t,其中 t=T−1,T−2,…,0t=T-1,T-2,\ldots,0。

更加形式化地,我们可以表示为:

q(xt∣xt−1):=N(xt;1−βtxt−1,βtI)q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}\right):=\mathcal{N}\left(\mathbf{x}_t ; \sqrt{1-\beta_t} \mathbf{x}_{t-1}, \beta_t \mathbf{I}\right)

这里 q(xt∣xt−1)q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}\right) 表示隐变量 xt\mathbf{x}_t 相对于 xt−1\mathbf{x}_{t-1} 的条件概率分布。也就是说,如果我们已知隐变量 xt−1\mathbf{x}_{t-1} 的取值,想要获得隐变量 xt\mathbf{x}_t 的取值,我们就要从这个关于 xt\mathbf{x}_t 的正态分布中采样,其均值为 1−βtxt−1\sqrt{1-\beta_t}\mathbf{x}_{t-1},方差为 βtI\beta_t\mathbf{I}。这里的数列 βt{\beta_t} 由人工手动定义,在原文的实现中实现为在 β1=10−4\beta_1=10^{-4} 到 βT=0.02\beta_T=0.02 的线性插值,这里 T=1000T=1000。直观上,每一步前向过程的操作就是对输入的数据加入高斯噪声的扰动。

在该算法中,从原始图片输入 x0\mathbf{x}_0 到完全的高斯噪声 xT\mathbf{x}_T 的过程是由一系列 qq 过程级联产生的。我们认为这个级联后的过程是一个马尔科夫过程,这意味着在任意时间 tt,当前状态 xt\mathbf{x}_t 的条件概率分布只依赖于其前一个状态 xt−1\mathbf{x}_{t-1},即:

q(xt∣xt−1,xt−2,…,x0)=q(xt∣xt−1)q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}, \mathbf{x}_{t-2}, \ldots, \mathbf{x}_0\right)=q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}\right)

这里 q(xt∣xt−1,xt−2,…,x0)q(\mathbf{x}_t \mid \mathbf{x}_{t-1}, \mathbf{x}_{t-2}, \ldots, \mathbf{x}_0) 表示在给定之前的所有状态的条件下,当前状态 xt\mathbf{x}_t 的条件概率分布,q(xt∣xt−1)q(\mathbf{x}_t \mid \mathbf{x}_{t-1}) 表示当前状态 xt\mathbf{x}_t 相对于 xt−1\mathbf{x}_{t-1} 的条件概率分布。根据马尔科夫过程的性质,我们有:

q(x1,x2,⋯ ,xT∣x0)=∏t=1Tq(xt∣xt−1)q(\mathbf{x}_1, \mathbf{x}_2, \cdots, \mathbf{x}_T \mid \mathbf{x}_0) =\prod_{t=1}^T q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}\right)

这里 q(x1,x2,⋯ ,xT∣x0)q(\mathbf{x}_1, \mathbf{x}_2, \cdots, \mathbf{x}_T \mid \mathbf{x}_0) 表示隐变量 x1,x2,⋯ ,xT\mathbf{x}_1, \mathbf{x}_2, \cdots, \mathbf{x}_T(之后简记为 x1:T\mathbf{x}_{1:T})相对于 x0\mathbf{x}_0 的联合条件概率分布。

同时,根据高斯分布的可叠加性,我们可以得出:

q(xt∣x0)=N(xt;αˉtx0,(1−αˉt)I),q\left(\mathbf{x}_t \mid \mathbf{x}_0\right)=\mathcal{N}\left(\mathbf{x}_t ; \sqrt{\bar{\alpha}_t} \mathbf{x}_0,\left(1-\bar{\alpha}_t\right) \mathbf{I}\right),

这里 αt:=1−βt\alpha_t:=1-\beta_t, αˉt:=∏s=1tαs\bar{\alpha}_t:=\prod_{s=1}^t \alpha_s。

去噪过程

我们希望去噪过程是上述前向过程的逆过程,也就是说,我们要获得 q(xt∣xt−1)q(\mathbf{x}_t \mid \mathbf{x}_{t-1}) 的逆分布。我们知道,如果 q(xt∣xt−1)q(\mathbf{x}_t \mid \mathbf{x}_{t-1}) 是正态分布且 βt\beta_t 足够接近 0,那么其逆过程也近似为一个正态分布。我们通过一个神经网络 θ\theta 来拟合这个正态分布的均值(与方差,Improved DDPM)。

pθ(xt−1∣xt):=N(xt−1;μθ(xt,t),Σθ(xt,t))p_\theta\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t\right):=\mathcal{N}\left(\mathbf{x}_{t-1} ; \boldsymbol{\mu}_\theta\left(\mathbf{x}_t, t\right), \boldsymbol{\Sigma}_\theta\left(\mathbf{x}_t, t\right)\right)

如果这个网络 θ\theta 被成功训练到可以拟合 pp 过程,那么我们就具有了一个具有“去噪”能力的网络。进而,我们可以从标准正态分布中采样 xT\mathbf{x}_T,然后经过 TT 次 pθp_\theta 的变换,便得到了具有真实感的图像 x0\mathbf{x}_0。

马尔可夫过程保证了:

pθ(x0:T):=p(xT)∏t=1Tpθ(xt−1∣xt)p_\theta\left(\mathbf{x}_{0: T}\right):=p\left(\mathbf{x}_T\right) \prod_{t=1}^T p_\theta\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t\right)

训练过程

训练的目标是通过模型生成的数据分布 pθ(x0)p_\theta(\mathbf{x}_0) 与真实数据分布 q(x0)q(\mathbf{x}_0) 尽可能相近。这可以通过最小化假设检验 E[−log⁡pθ(x0)]\mathbb{E}\left[-\log p_\theta\left(\mathbf{x}_0\right)\right] 来实现。由于:

pθ(x0)=∫pθ(x0:T)dx1:Tpθ(x0:T)=pθ(xT)∏t=1Tpθ(xt−1∣xt)\begin{aligned} p_\theta\left(\boldsymbol{x}_0\right) & =\int p_\theta\left(\boldsymbol{x}_{0: T}\right) d \boldsymbol{x}_{1: T}\\ p_\theta\left(\boldsymbol{x}_{0: T}\right) & =p_\theta\left(\boldsymbol{x}_T\right) \prod_{t=1}^T p_\theta\left(\boldsymbol{x}_{t-1} \mid \boldsymbol{x}_t\right) \end{aligned}

我们尝试去推出 E[−log⁡pθ(x0)]\mathbb{E}\left[-\log p_\theta\left(\mathbf{x}_0\right)\right] 的上界,通过将其上界优化小的方式去优化该假设检验值:

Lce=−Eq(x0)(log⁡pθ(x0))=−Eq(x0)(log⁡∫pθ(x0:T)dx1:T)=−Eq(x0)(log⁡∫q(x1:T∣x0)pθ(x0:T)q(x1:T∣x0)dx1:T)=−Eq(x0)(log⁡Eq(x1:T∣x0)(pθ(x0:T)q(x1:T∣x0)))≤−Eq(x0)(Eq(x1:T∣∣x0)(log⁡pθ(x0:T)q(x1:T∣x0)))=−∬q(x0)q(x1:T∣x0)log⁡pθ(x0:T)q(x1:T∣x0)dx0dx1:T=−∫q(x0:T)log⁡pθ(x0:T)q(x1:T∣x0)dx0:T=−Eq(x0:T)[log⁡pθ(x0:T)q(x1:T∣x0)]=Eq(x0:T)[log⁡q(x1:T∣x0)pθ(x0:T)]\begin{aligned} \mathcal{L}_{c e} & =-\mathbb{E}_{q\left(\boldsymbol{x}_0\right)}\left(\log p_\theta\left(\boldsymbol{x}_0\right)\right) \\ & =-\mathbb{E}_{q\left(\boldsymbol{x}_0\right)}\left(\log \int p_\theta\left(\boldsymbol{x}_{0: T}\right) d \boldsymbol{x}_{1: T}\right) \\ & =-\mathbb{E}_{q\left(\boldsymbol{x}_0\right)}\left(\log \int q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right) \frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)} d \boldsymbol{x}_{1: T}\right) \\ & =-\mathbb{E}_{q\left(\boldsymbol{x}_0\right)}\left(\log \mathbb{E}_{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}\left(\frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}\right)\right) \\ & \leq-\mathbb{E}_{q\left(\boldsymbol{x}_0\right)}\left(\mathbb{E}_{q\left(\boldsymbol{x}_{1: T \mid} \mid \boldsymbol{x}_0\right)}\left(\log \frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}\right)\right) \\ & =-\iint q\left(\boldsymbol{x}_0\right) q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right) \log \frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)} d \boldsymbol{x}_0 d \boldsymbol{x}_{1: T} \\ & =-\int q\left(\boldsymbol{x}_{0: T}\right) \log \frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)} d \boldsymbol{x}_{0: T} \\ & =-\mathbb{E}_{q\left(\boldsymbol{x}_{0: T}\right)}\left[\log \frac{p_\theta\left(\boldsymbol{x}_{0: T}\right)}{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}\right]=\mathbb{E}_{q\left(\boldsymbol{x}_{0: T}\right)}\left[\log \frac{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}{p_\theta\left(\boldsymbol{x}_{0: T}\right)}\right] \end{aligned}

这里用了变分自编码器(VAE)中的重要不等式,通常称为“ELBO(evidence lower bound)不等式”。下面对式子进行解释:

左边的期望值是关于潜在变量 z\mathbf{z} 的先验分布 p(z)p(\mathbf{z}) 取期望后的结果,其中 z\mathbf{z} 通过生成模型 pθ(x0,z)p_\theta(\mathbf{x}_0, \mathbf{z}) 与观测变量 x0\mathbf{x}_0 相关联。根据贝叶斯定理,我们有:

pθ(x0,z)=pθ(x0∣z)p(z)p_\theta\left(\mathbf{x}_0, \mathbf{z}\right)=p_\theta\left(\mathbf{x}_0 \mid \mathbf{z}\right) p(\mathbf{z})

因此,可以将左边的期望值写成以下形式:

E[−log⁡pθ(x0)]=Ep(z)[−log⁡pθ(x0∣z)]−H[p(z)]\mathbb{E}\left[-\log p_\theta\left(\mathbf{x}_0\right)\right]=\mathbb{E}_{p(\mathbf{z})}\left[-\log p_\theta\left(\mathbf{x}_0 \mid \mathbf{z}\right)\right]-\mathbb{H}[p(\mathbf{z})]

其中,H[p(z)]\mathbb{H}\left[p(\mathbf{z})\right] 是潜在变量的先验分布 p(z)p(\mathbf{z}) 的熵,可以看作是潜在变量的不确定度的度量。在我们的例子中,潜在变量 z\mathbf{z} 为 x1:T\mathbf{x}_{1:T}。

接下来我们用马尔科夫过程的性质把 Eq(x0:T)[log⁡q(x1:T∣x0)pθ(x0:T)]\mathbb{E}_{q\left(\boldsymbol{x}_{0: T}\right)}\left[\log \frac{q\left(\boldsymbol{x}_{1: T} \mid \boldsymbol{x}_0\right)}{p_\theta\left(\boldsymbol{x}_{0: T}\right)}\right] 中的联合概率分布拆开。同时,因为 q(xt∣xt−1)q\left(\mathbf{x}_t \mid \mathbf{x}_{t-1}\right) 的分布的 closed-form solution 不可知,我们引入 x0\mathbf{x}_0 后利用贝叶斯公式可以转换成 q(xt−1∣xt,x0)q\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t, \mathbf{x}_0\right),这个分布的参数为:

q(xt−1∣xt,x0)=N(xt−1;μ~t(xt,x0),β~tI)whereμ~t(xt,x0):=αˉt−1βt1−αˉtx0+αt(1−αˉt−1)1−αˉtxtandβ~t:=1−αˉt−11−αˉtβtq\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t, \mathbf{x}_0\right)=\mathcal{N}\left(\mathbf{x}_{t-1} ; \tilde{\boldsymbol{\mu}}_t\left(\mathbf{x}_t, \mathbf{x}_0\right), \tilde{\beta}_t \mathbf{I}\right) \\ \text{where} \quad \tilde{\boldsymbol{\mu}}_t\left(\mathbf{x}_t, \mathbf{x}_0\right):=\frac{\sqrt{\bar{\alpha}_{t-1}} \beta_t}{1-\bar{\alpha}_t} \mathbf{x}_0+\frac{\sqrt{\alpha_t}\left(1-\bar{\alpha}_{t-1}\right)}{1-\bar{\alpha}_t} \mathbf{x}_t \quad \\ \text{and} \quad \tilde{\beta}_t:=\frac{1-\bar{\alpha}_{t-1}}{1-\bar{\alpha}_t} \beta_t

最终我们发现上述上界等价于:

Eq[DKL(q(xT∣x0)∥p(xT))⏟LT+∑t>1DKL(q(xt−1∣xt,x0)∥pθ(xt−1∣xt))⏟Lt−1−log⁡pθ(x0∣x1)⏟L0]\mathbb{E}_q[\underbrace{D_{\mathrm{KL}}\left(q\left(\mathbf{x}_T \mid \mathbf{x}_0\right) \| p\left(\mathbf{x}_T\right)\right)}_{L_T}+\sum_{t>1} \underbrace{D_{\mathrm{KL}}\left(q\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t, \mathbf{x}_0\right) \| p_\theta\left(\mathbf{x}_{t-1} \mid \mathbf{x}_t\right)\right)}_{L_{t-1}} \underbrace{-\log p_\theta\left(\mathbf{x}_0 \mid \mathbf{x}_1\right)}_{L_0}]

我们希望的优化目标,便是这些概率分布之间的 KL 散度。

优化目标的进一步改进

我们考虑 Lt−1L_{t-1},由于计算 KL 散度的两个分布都是正态分布,我们可以直接得到闭式解:

Lt−1=Eq(x0,xt)[12σt2∥μ~(xt,x0)−μθ(xt,t)∥2]+C\begin{aligned} \mathcal{L}_{t-1} =\mathbb{E}_{q\left(\boldsymbol{x}_0, \boldsymbol{x}_t\right)}\left[\frac{1}{2 \sigma_t^2}\left\|\tilde{\boldsymbol{\mu}}\left(\boldsymbol{x}_t, \boldsymbol{x}_0\right)-\boldsymbol{\mu}_\theta\left(\boldsymbol{x}_t, t\right)\right\|^2\right]+C \end{aligned}

这相当于直接预测 pθp_\theta 过程的均值。

而由于我们在训练过程中知道前向过程 xt=αˉtx0+1−αˉtϵ\mathbf{x}_t=\sqrt{\bar{\alpha}_t} \mathbf{x}_0+\sqrt{1-\bar{\alpha}_t} \boldsymbol{\epsilon},且在训练过程中要将 μθ(xt,t)\boldsymbol{\mu}_\theta\left(\boldsymbol{x}_t, t\right) 回归到的值只与 x0\boldsymbol{x}_0 和 xt\boldsymbol{x}_t 有关,于是我们可以代入消去这个回归值中的 x0\boldsymbol{x}_0,得到我们要把 μθ(xt,t)\boldsymbol{\mu}_\theta\left(\boldsymbol{x}_t, t\right) 回归到:

1αt(xt−βt1−αˉtϵ)\frac{1}{\sqrt{\alpha_t}}\left(\mathbf{x}_t-\frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}} \boldsymbol{\epsilon}\right)

而这里的 xt\boldsymbol{x}_t 是 μθ(xt,t)\boldsymbol{\mu}_\theta\left(\boldsymbol{x}_t, t\right) 的输入。本着简便的原则,我们可以设计:

μθ(xt,t)=1αt(xt−βt1−αˉtϵθ(xt,t))\boldsymbol{\mu}_\theta\left(\boldsymbol{x}_t, t\right) = \frac{1}{\sqrt{\alpha_t}}\left(\mathbf{x}_t-\frac{\beta_t}{\sqrt{1-\bar{\alpha}_t}} \boldsymbol{\epsilon}_\theta\left(\boldsymbol{x}_t, t\right)\right)

也就是说,我们的网络 ϵθ\boldsymbol{\epsilon}_\theta 最终只需要输入 xt\boldsymbol{x}_t 和当前时间的 time embedding,输出我们在前向过程中相对原图添加的噪声即可。

于是我们可以对 Loss 稍作修改:

Ex0,ϵ[βt22σt2αt(1−αˉt)∥ϵ−ϵθ(αˉtx0+1−αˉtϵ,t)∥2]\mathbb{E}_{\mathbf{x}_0, \epsilon}\left[\frac{\beta_t^2}{2 \sigma_t^2 \alpha_t\left(1-\bar{\alpha}_t\right)}\left\|\boldsymbol{\epsilon}-\boldsymbol{\epsilon}_\theta\left(\sqrt{\bar{\alpha}_t} \mathbf{x}_0+\sqrt{1-\bar{\alpha}_t} \boldsymbol{\epsilon}, t\right)\right\|^2\right]

再简便一些,我们丢弃前面的系数:

Lsimple (θ):=Et,x0,ϵ[∥ϵ−ϵθ(αˉtx0+1−αˉtϵ,t)∥2]L_{\text {simple }}(\theta):=\mathbb{E}_{t, \mathbf{x}_0, \epsilon}\left[\left\|\boldsymbol{\epsilon}-\boldsymbol{\epsilon}_\theta\left(\sqrt{\bar{\alpha}_t} \mathbf{x}_0+\sqrt{1-\bar{\alpha}_t} \boldsymbol{\epsilon}, t\right)\right\|^2\right]

这相当于对于不同时间步的 Loss 做了一个分配不同权重的操作。事实上,这里将 tt 较小的时间步的 Loss 权重降低,使得模型不用花费太多精力在考虑 fine-grained 的细节上。

Reference

除了原论文外,本节内容的整理我们参考了以下内容:

感觉水够一篇的篇幅了,换一篇接着写 :)